百度做词元所,想给Token交易补一块基础设施

作者:连禾 ;编辑:嘉辛
一百多年前,兴修铁路是美国最热门的投资领域,为了筹集资金,各个铁路公司铺一段路就发一笔债,债券数量迅速膨胀。由于各家财报口径混乱、真假难辨,在厚厚的资料堆面前,普通投资者很难看清哪张会兑付、哪张会违约。
1909 年,约翰・穆迪做了件不一样的事。他在《铁路投资分析》里,开始系统地给铁路债券做评级,给每种债券标注一个字母,把庞杂的经营与财务分析,浓缩成普通人能看得懂的风险符号,现代债券评级由此发端。
美国铁路业的发展,反映了所有行业发展的一个规律:当一个市场供给多到买方挑不过来、又无从验证时,买方的焦虑就会转变:稀缺时怕买不到,丰富之后怕买错。专业评价和信用机制就会从可选项变成刚需。
AI 产业正走到同一个路口。过去几年,AI行业主要在补模型能力和算力供给,如今模型和智能体应用快速普及,全国日均词元调用量两年半涨了约5000 倍。
供给增加不等于市场成熟。Token 可以计量,却未必能比较质量,模型能调用,验证服务始终没跟上,交易也可以完成,但不一定都能沉淀信用。
面对这个痛点,2026 年 11 月12日的百度世界大会上,百度智能云推出大模型交易平台:词元所,把验真和征信做成交易的前置条件。一个无法保证所见即所得的市场,如何长成一个产业?这是它要回答的问题。
一、一个正在失灵的 Token 市场
一百多年前美国铁路债券的那一幕,正在 Token 市场重演,症状同样典型。
Token服务天然有三个特征:
一是黑盒化。调用方只能看到输入和输出,屏幕背后跑的到底是不是供应商宣称的那个模型版本,是否经过量化裁剪,实际效果与标称能力是否一致,都不是仅凭接口名称和报价就能判断的。
二是动态化。版本迭代、负载调整都发生在供给方一侧,模型可能被悄悄升级或替换,输出质量一夜漂移,客户毫不知情。
三是非标准化。行业尚未形成统一的评价标准。不同供应商对模型性能、服务质量等指标的披露口径不一,企业即使能比较Token价格,也很难判断实际服务质量。
这三个特征对应了三个结果:质量难比较、服务难验证、信用难沉淀。
一条完整的劣币驱逐良币链条由此产生:客户分辨不出好坏,只敢按平均水平出价,诚信经营的供应商成本更高,却拿不到相应溢价,优质供给一步步被挤出,市场平均质量在往下走。
造成恶性循环的根源,是 “好”无法被观察、被奖励。
Token交易规模化还在放大这套机制的代价。
过去两年半,全国日均词元调用量涨了约 5000 倍,新模型几乎每天都在出现。供给在爆发,交易规则却没有标准化。结果是效率没有提升,交易成本越来越高。
相关的制度层面已经明确,词元从一个技术计量单位,变成被制度承认的交易对象。
但智能要成为真正的商品,得先跨过三道门槛:可比价,让供给进入统一计量体系。可验证,让标称质量能够被识别。可追责,让履约和信用能够沉淀。
换句话说,能买到从来不是门槛,同样的钱买到同样的东西、换了版本效果不变、出了问题有人负责,才是门槛。
要素市场都走过同一条路。电力交易需要统一计量、供电质量考核和结算规则。通信服务有话单记录、服务质量指标和相应的履约要求。数据要素市场也在探索登记、质量评价和合规审计机制。
这些行业的商品属性各不相同,但有一个共同点,市场要形成稳定交易,先有统一度量衡才有价格,先有第三方质检才有品牌,先有履约记录才有长期合约。
AI 服务缺的,正是这样一套买卖双方共用的参照系。
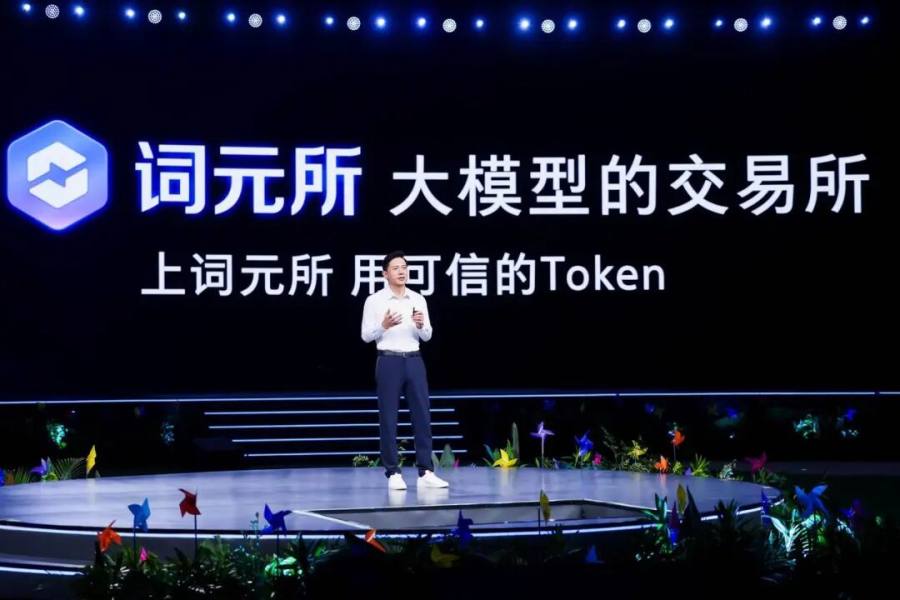
11月12日,百度智能云正式发布大模型交易平台“词元所”,尝试解决Token服务难以验证、缺少统一评价标准的问题。它的运转机制,可以概括为三次修复。
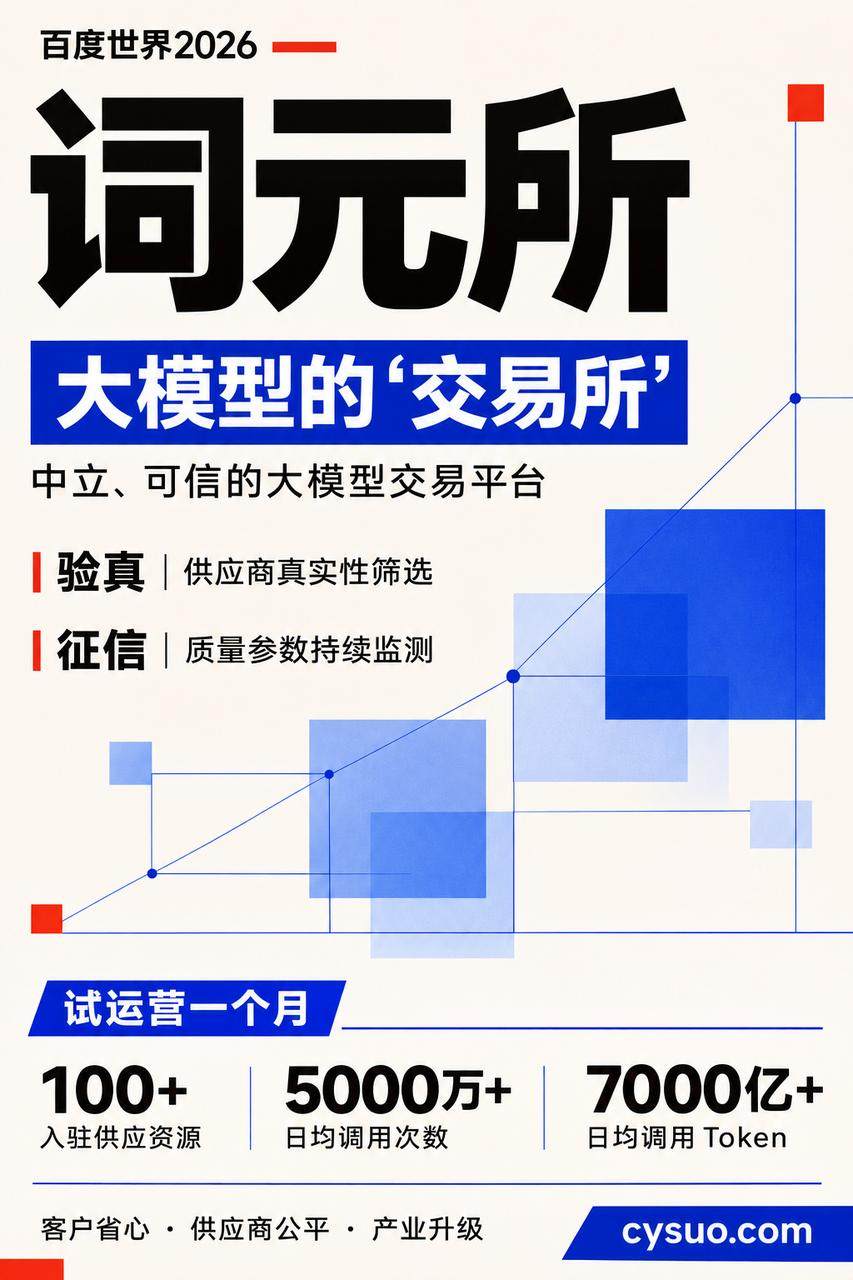
第一次是验真,让质量看得见。 模型指纹比对确认调用的是不是宣称的模型,能力、性能和可用性测试确认标称与实际是否一致,套壳、裁剪、静默升级在准入环节就被挡住。
第二次是计量加双评分,让质量可比较。 除了统一计量口径,还把质量分和信用分服务水平量化、分层,不同供应商第一次站在同一张表上被比较。
第三次是征信,让质量可信。 定期拨测加上全链路实时监测,供应商表现被持续记录,评级变化主动提示。一次交易从此沉淀为可查询的履约历史,而不是一锤子买卖。
三次修复合起来,改变了市场的计价方式。过去 Token 市场只有价格一个计价单位,竞争只能往降价一条路上走。信用分成为第二个计价单位之后,价格第一次有机会反映质量,而不是反映信息差。
长期稳定供货的厂商,信用会随时间增值,靠谱第一次能卖出溢价。竞争由此从价格战,变成价格加信用的二维质量战。
从关系型交易到规则型交易,这才是它真正的机制含义。
二、平台价值怎么落地?
词元所已经有了一定的运行规模。
百度披露,试运行一个月以来,词元所入驻供应资源超过100个,日均调用次数突破5000万,日均调用Token超过7000亿。
随着越来越多的模型服务和调用需求汇集到平台,词元所也开始在供需两端发挥作用,一方面帮助企业更便捷地采购AI服务,另一方面为模型供应商提供新的销售渠道。
先看需求端。企业采购AI服务,成本往往不止Token账单。如果同时接入多家模型供应商,除了比价、测试和接口适配,还需要持续监控服务质量。一旦出现故障,问题究竟出在模型、服务平台还是应用端,也需要花费时间排查。
这些成本不一定体现在采购账单上,却影响着AI能否进入企业的日常运营。
过去,不少AI应用依靠专项预算推进,项目验收后采购便告一段落。但当AI开始长期承担客服、营销、软件开发等工作,模型调用就会成为持续性的运营支出,企业需要确保费用可预测、服务可追溯、责任可划分。
尤其对预算有限的中小企业、依靠模型能力开发产品的ISV,以及采购流程严格的国企客户来说,自行建立完整的评测和供应商管理体系并不容易。
词元所提供的服务质量数据和供应商履约记录,可以为企业提供统一的采购参考,减少重复评测和选型成本,也让AI服务更有条件进入年度运营预算。
另一方面,词元所也在帮助模型服务供应商拓展销售渠道,让已有算力资源获得更多订单。
目前,国内算力市场存在“算力荒”与“算力躺”并存的现象。
中国信息通信研究院数据显示,2025年我国智能算力供算量约38亿卡时,同期实际用算量仅14亿卡时,算力实际使用率约36.8%,超六成建成算力处于闲置状态。
同时,高端智算资源依然紧张,部分地方智算中心却面临利用率不足的问题。
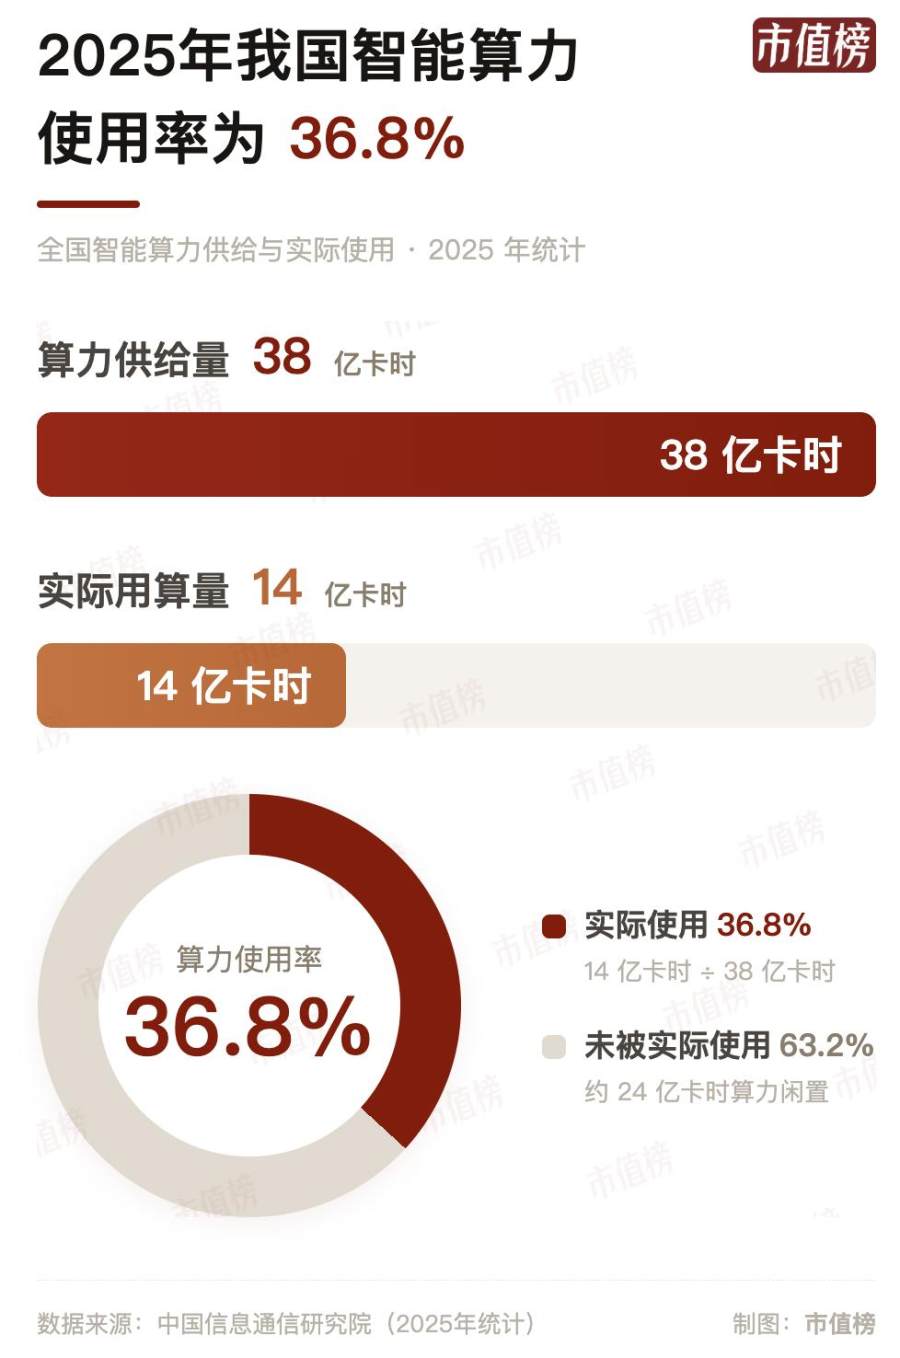
这种矛盾主要来自算力供需的结构性错配。
从算力类型来看,高端训练算力需求旺盛,部分中低端算力仍需寻找适合的应用场景。从区域分布来看,京津冀、长三角和粤港澳地区集中了全国65%以上的算力需求,而西部部分算力资源受网络时延、跨区域调度等限制,难以直接承接实时业务。
工信部信息通信经济专家委员会委员盘和林指出,词元所让具备模型服务能力的供给方进入公开市场,为存量算力增加了一个可被检索、可被比价的变现出口,提升了算力的可售性与配置效率。
运营能力也影响算力的使用效率。一些算力项目建成后,由于缺乏模型部署和底层算法优化经验,利用率长期不高。引入原厂技术团队驻场调优后,部分项目的利用率能够提升至80%以上。
事实上,一家算力中心从建成到产生收入,还需要完成模型部署、推理优化和运维保障,将算力转化为稳定可调用的API服务,再向客户证明服务质量,并找到愿意付费的买家。
对于具备模型服务能力、但缺少品牌和销售渠道的中小算力中心、地方国资平台来说,后两个环节尤其重要。词元所提供了新的交易渠道。通过统一展示价格、性能和履约记录,供应商可以触达更多潜在客户,采购方也能找到符合自身需求的模型服务。
随着各地智算基础设施逐步建成,如何提高存量算力的使用效率,正变得越来越重要。词元所通过连接供需双方,有机会让更多已有算力转化为实际订单,提高整个产业的资源利用效率。
03三为什么是百度?
词元所要做的,不止是把模型供给和客户需求拉到一张桌子上。撮合是起点,真正难的是让智能服务被识别、被验证、被信任,最后沉淀成持续稳定的交易。这些环节,光靠模型和流量能力还远远不够,每一步都需要平台建立新的能力。
第一,质量怎么被识别?
模型服务不像标准商品,参数和宣传指标并不能完全代表实际质量。
微软研究人员发现,一些模型仅凭问题描述、不查看代码库结构,就能以最高76%的准确率指出Bug所在文件。但在该基准未覆盖的仓库中,这一数字降至53%。这说明基准成绩可能受到数据记忆等因素影响,未必完全反映模型解决新问题的能力。
即使模型本身不变,实际服务表现也可能因运行环境而异。Hugging Face首席政策官指出,一个能力较弱的模型,配合更好的运行框架,也可能超过前沿模型。
外部看到的“强”和真实场景里的“可靠”,往往隔着缝隙。
百度长期从事模型研发、训练与评测,更理解模型能力的真实边界,也更清楚如何识别表面优化与实际能力之间的差异。
第二,质量怎么被持续证明?
模型不是一次交付就结束的商品。版本迭代、推理栈更新、负载结构变化,都可能让同一个模型名称下的实际体验发生漂移。
持续抽检拨测本质上是在跑真实的推理负载,它消耗算力,占用调度资源,长文本还会带来额外开销。换句话说,监测本身就是一门工程,而且是要在真实负载里一直跑下去的工程。
百度在大规模推理系统里积累的调度、限流和成本控制经验,正好涉及这些实际问题。把这些环节理顺,验证才能从偶尔一次的抽检,变成日常运行的一部分。
第三,评价怎么连接真实交易?
不同企业对延迟、稳定性、成本的权重完全不同,金融客户不能容忍延时,内容生成场景可能更在意单位成本。实验室里再高的分数,如果回答不了客户各自的权重,就只是分数。
千帆在一个供给高度分散的环境中做过这件事:接入近百个大模型,服务超40万家客户,Agent数量超过130万。
比规模更重要的是,百度能够接触到不同企业的差异化需求,了解客户在调用过程中关注哪些指标、容易遇到哪些问题。
第四,信用怎么真正影响交易?
真正有用的信用评价,要能进入供应商筛选、采购准入和履约管理,在出现问题时也能成为追责依据。
政企采购最能体现这一要求。对这类客户来说,模型效果只是采购决策的一部分,系统稳定性、项目交付能力和长期运维成本同样重要。
百度智能云长期服务政企客户,根据云行业机构智能超参数统计,2026年1—9月,百度智能云以90个中标项目、15.92亿元披露中标金额居云厂商首位,服务80%央企和100%的系统重要性银行,更加清楚评价结果如何呈现才经得起采购审查并在履约中被使用。
这四道门槛是层层递进的。单看其中任何一项,不少厂商都有相应能力,真正难的是把它们连起来。
对模型足够了解,才能设计出有区分度的验真方法,百度在大规模推理中的积累是质量监测能不能长期做下去的关键。而千帆积累的客户服务经验、百度智能云在政企市场的实践,则让评价指标更贴近实际需求,也让信用评价有机会进入真实的采购流程。
芯片、云、模型和平台,百度全栈能力使得模型验真、服务监测和交易评价能够在同一套技术和业务体系中开展,降低长期运行的成本。
由此,词元所才可能从一次性评测展示,走向质量验证与信用评价的持续服务。
回头看1909年的穆迪,他不修铁路也不买债券,他生产的是判断,让远在欧洲的资本敢于把钱交给素未谋面的铁路公司,一个市场的信任半径,就这样被撑开了。
词元所处的位置相似,经营的是让智能信得过的整套机制。当靠谱可以被持续证明、被合理定价,诚信经营的供给拿得到溢价,谨慎观望的买方敢于下单,智能才算真正走完从技术到商品、从生意到产业的最后一段路。
